循环工程,就是用你设计的系统来取代你自己去提示 Agent。这里的"循环"可以理解为一个递归目标——你定义一个目的,AI 持续迭代直到完成。它大致由五个构建块组成,Claude Code 和 Codex 目前都已具备这五个模块。
我认为,这可能就是我们未来与编程 Agent 协作的方式。不过目前还很早期,我持怀疑态度,而且你必须格外注意 token 成本(如果你的 token 是充裕还是紧缺的,使用模式会大相径庭)。你还需要某种方式确保质量不下滑,关于"AI 生成垃圾内容"的担忧也是有道理的。但话说回来,让我们来探索一下这究竟是怎么回事。
@steipete 最近说过:"你不该再直接提示编程 Agent 了,你应该设计那些去提示 Agent 的循环。" 同样地,Anthropic Claude Code 负责人 @bcherny 说:"我不再直接提示 Claude 了,我有循环在运行,负责提示 Claude 并决定下一步做什么。我的工作是编写循环。"
那么,这究竟意味着什么?
在过去大约两年里,从编程 Agent 那里获得产出的方式,是你写一个好提示并提供足够的上下文。你输入一件事,读取返回内容,再输入下一件事。Agent 是一个工具,你一直握着它,一轮接一轮。这种方式基本上已经成为过去式,或者至少有些人认为会是这样。
现在你构建一个小系统,它负责发现工作、分配任务、检查结果、记录已完成的事项,然后决定下一步——让这个系统去触发 Agent,而不是你来触发。我之前写过与之相关的"Agent 框架工程",也就是为单个 Agent 运行创造运行环境,以及"工厂模式"——构建软件的系统。循环工程比框架高一层:它是带有定时器的框架,能生成小助手,并且能自我驱动。
让我感到惊讶的是,这已经不再是一个工具层面的问题了。一年前,如果你想要一个循环,你得写一堆 Bash 脚本,永远自己维护,那是你的私有物。而现在,这些组件已经内置在产品里了。Steinberger 的清单几乎完全对应 Codex 应用的功能,同样也对应 Claude Code。一旦你发现两者的形状是一样的,你就不再争论用哪个工具了,你只需设计一个无论用哪个工具都能运行的循环。
五个模块,以及相关说明
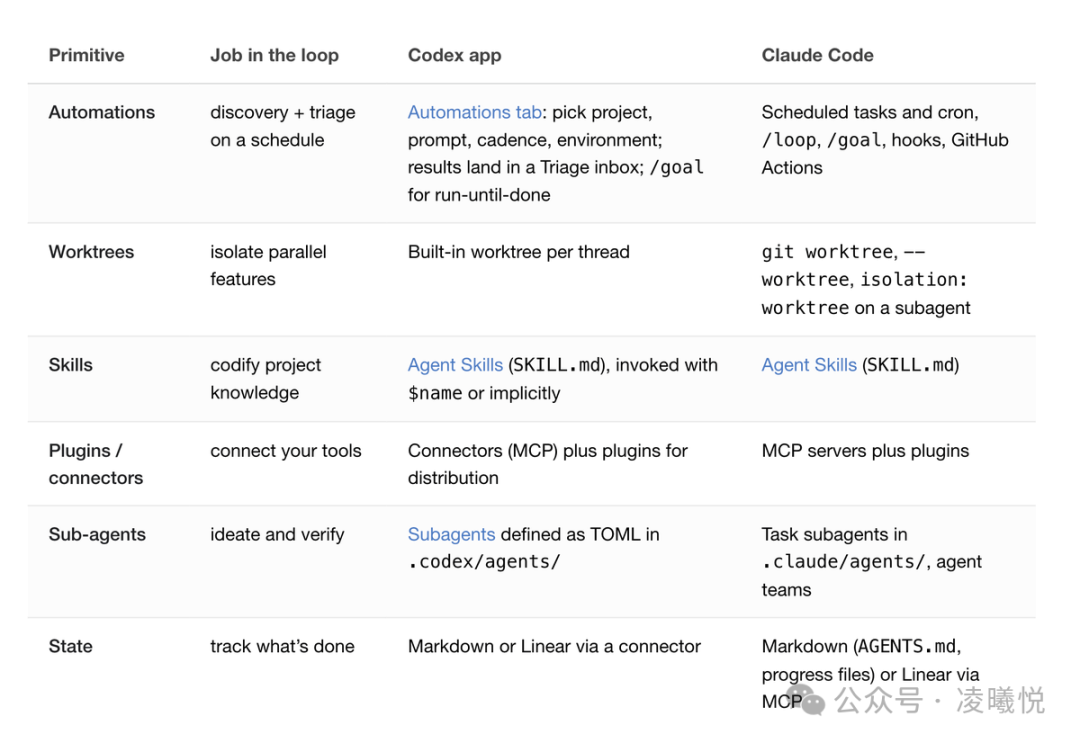
一个循环需要五样东西,再加上一个记忆存储。让我先列出来,然后逐一对应。
- 定时自动运行的"自动化任务",自主完成发现和分类。
- Worktree(工作树),让并行运行的 Agent 不互相干扰。
- Skills(技能),记录项目知识,否则 Agent 只能靠猜测。
- 插件和连接器,将 Agent 接入你已经使用的工具。
- Sub-agents(子 Agent),让一个负责想方案,另一个负责审核。
然后是第六样东西:记忆。一个 Markdown 文件,或者一个 Linear 看板,任何存在于单次对话之外、记录已完成事项和下一步计划的东西。听起来太简单了,但这是所有长期运行 Agent 依赖的同一个技巧——模型在每次运行之间会忘记一切,所以记忆必须存在磁盘上,而不是在上下文里。Agent 会遗忘,但代码仓库不会。
两款产品现在都具备了这五个模块。
名称在各处略有不同,但能力是一样的。让我逐一介绍,因为说实话,细节才是决定一个循环究竟稳固还是悄悄到处漏水的关键。
自动化任务,这是循环的心跳
自动化任务让循环成为真正的循环,而不只是你做一次就完了的单次运行。在 Codex 应用里,你在"自动化任务"标签页创建一个,选择项目、要运行的提示、运行频率,以及是在本地 checkout 还是在后台 worktree 上运行。有发现内容的运行结果会进入"分类收件箱",没有发现内容的运行结果则自动归档,挺好的设计。OpenAI 内部将其用于日常事务,比如每日 Issue 分类、汇总 CI 失败信息、编写提交摘要、排查上周引入的 Bug。一个自动化任务可以调用一个 Skill,所以你可以让重复性任务保持可维护性——通过调用 $skill-name,而不是把一大段无人会去更新的巨型说明粘贴到定时任务里。
Claude Code 通过调度(scheduling)和钩子(hooks)实现了同样的效果。你可以用 /loop 按间隔运行提示或命令,可以调度定时任务,可以通过钩子在 Agent 生命周期的特定时间点触发 Shell 命令,或者如果你想在关上笔记本后仍继续运行,就把整个任务推送到 GitHub Actions。思路完全一样:定义一个自主任务,给它设置节奏,让结果来找你,而不是你四处去检查。
还有一个值得了解的会话内原语,也是整篇文章更核心的内容。/loop 按节奏重复运行;/goal 则持续运行,直到你写下的条件真正成立为止——每一轮之后,一个独立的小模型会检查任务是否完成,所以写代码的 Agent 不是给自己打分的那个。你给它类似"test/auth 里所有测试通过且 lint 干净"这样的条件,然后离开。Codex 有同样的功能,也叫 /goal,它跨轮次持续工作,直到可验证的停止条件成立,还支持暂停、恢复和清除。同一个原语,两款工具都有——这也是本文贯穿始终的模式。
所以这部分负责浮现工作。循环的其余部分负责处理这些工作。
Worktree,让并行不演变成混乱
一旦你同时运行多个 Agent,文件就开始冲突,这就会成为失败的根源。两个 Agent 写同一个文件,和两个工程师提交到同一行代码且互相没沟通,是完全一样的麻烦。Git worktree 解决了这个问题——它是一个独立的工作目录,位于自己的分支上,共享同一个仓库历史,所以一个 Agent 的编辑根本不可能触及另一个 Agent 的 checkout。
Codex 内置了 worktree 支持,让多个线程同时访问同一个仓库而不互相碰撞。Claude Code 通过 git worktree、用于在独立 checkout 中打开会话的 --worktree 标志,以及你可以附加在 sub-agent 上的 isolation: worktree 设置来实现同样的隔离,每个助手都获得一个运行完成后会自动清理的全新 checkout。worktree 消除了机械层面的冲突,但你依然是上限,你的审查带宽决定了你实际能运行多少个,而不是工具。
Skills,让你不再每次都要把项目从头解释一遍
Skill(技能)是让你停止在每次会话中重新解释同一个项目上下文的方式。两款工具使用相同的格式:一个包含 SKILL.md 的文件夹,里面存着说明和元数据,以及可选的脚本、参考资料和素材。Codex 在你用 $ 或 /skills 调用时运行技能,或者当你的任务与技能描述匹配时自动运行——这就是为什么简洁无聊的描述比巧妙的描述更好。Claude Code 的工作方式相同。
技能也是让意图不再一次次消耗你的地方。Agent 每次会话都从零开始,它会用自信的猜测填补你意图中的任何空缺。技能就是把意图写在外部的方式——规范、构建步骤、"我们不这样做是因为那次事故"——一次性写下,让 Agent 在每次运行时都能读到。没有技能,循环每个周期都要从零重新推导你的整个项目;有了技能,它就像是在不断积累。
有一点要搞清楚:技能是编写格式,插件是分发方式。当你想跨仓库共享技能,或者打包几个技能在一起时,你把它们封装成插件。在 Codex 中如此,在 Claude Code 中也如此。
插件和连接器,让循环触达你真实的工具
一个只能看到文件系统的循环是个微型循环。连接器基于 MCP 构建,让 Agent 能读取你的 Issue 追踪器、查询数据库、访问 Staging API、在 Slack 里发消息。Codex 和 Claude Code 都支持 MCP,所以你为一款工具写的连接器通常在另一款里也能直接用。插件将连接器和技能打包在一起,这样你的队友安装你的配置只需一步,而不用从记忆里重新搭建整套东西。
这就是"一个说'这是修复方案'的 Agent"和"一个能自己开 PR、链接 Linear 工单、在 CI 通过后 ping 频道的循环"之间的区别。连接器让循环能在你真实的环境里采取行动,而不只是告诉你它如果能做会怎么做。
Sub-agents,让创作者远离检查者
循环中迄今为止最有用的结构设计,是将编写者和检查者分开。写代码的模型在给自己的作业打分时太过宽松了。一个拥有不同指令、有时甚至是不同模型的第二个 Agent,会抓住第一个自我说服忽略的那些问题。
Codex 只在你要求时才生成 sub-agent,同时运行它们,然后将结果折叠回一个答案。你在 .codex/agents/ 里定义自己的 Agent,每个都有名称、描述、指令,以及可选的模型和推理力度。Claude Code 用 .claude/agents/ 里的 sub-agent 和在 Agent 之间传递工作的 Agent 团队实现同样的功能。两者中常见的分工是:一个 Agent 探索,一个 Agent 实现,一个 Agent 对照规格书验证。
Sub-agent 确实会消耗更多 token,因为每个都要做自己的模型推理和工具调用,所以把它们花在值得花第二份精力的地方。这基本上也是 Claude Code 的 /goal 在底层做的事情——一个全新的模型来决定循环是否完成,而不是做这项工作的那个模型,创作者与检查者的分离被应用到了停止条件本身上。
一个循环是什么样子的
把它们拼在一起,一条单线程变成了一个小型控制面板。这里有一个反复使用的形态:
一个自动化任务每天早晨在仓库上运行。它的提示调用一个分类技能,读取昨天的 CI 失败、未解决的 Issue 和近期的提交,将发现写入一个 Markdown 文件或 Linear 看板。对于每一个值得处理的发现,该线程会打开一个隔离的 worktree,并派一个 sub-agent 起草修复方案,再派第二个 sub-agent 对照项目技能和现有测试审查该草案。
连接器让循环能够开 PR 并更新工单。任何循环无法处理的内容会进入分类收件箱。状态文件是整个系统的骨架,它记住了什么被尝试过、什么通过了、什么还在进行中,所以明天早晨的运行会从今天停下的地方继续。
想想你实际上做了什么:你只设计了一次。你没有提示那些步骤中的任何一个。这就是 Steinberger 的全部观点的现实体现——而且无论在 Codex 里还是在 Claude Code 里,这是同一个循环,因为这些模块是一样的模块。
循环仍然无法为你做的事
循环改变了工作,但它不会把你从工作中删除。而且随着循环越来越好,三个问题反而会变得更尖锐,而不是更简单。
验证仍然是你的事。 一个无人值守的循环,同时也是一个无人值守地犯错的循环。你之所以要把验证 sub-agent 从创作 sub-agent 中分离出来,是为了让循环的"完成了"这句话有些分量——即便如此,"完成了"是一个主张,而不是一个证明。你的工作是交付你确认可以运行的代码。
如果你放任自流,你的理解会腐蚀。 循环交付你没有写的代码越快,你所知道的和实际存在的之间的差距就越大。这就是"理解债",而一个顺畅的循环只会让它增长得更快,除非你去阅读循环生产的内容。
舒适的姿态可能是危险的那种。 当循环自行运行时,很容易停止持有观点,只是接受它给你的东西——"认知投降"。设计循环是一剂解药,当你带着判断力去做它时;而当你去做它只是为了逃避思考时,它就是加速剂。同样的行为,截然相反的结果。
构建循环,保持工程师身份
我认为这是我们工作方式演进的一个预告。话虽如此,如果我不亲自审查代码,或者完全依赖自动化循环来修复代码,我的产品质量就会受损。我很可能会陷入一个螺旋下降,不断挖深自己的坑。
话说回来,去建立你的循环吧,但不要忘记直接提示你的 Agent 依然有效。关键在于找到正确的平衡。
循环对不同的人会产生不同的结果。两个人可以构建完全相同的循环,却得到完全相反的结果。一个用它在深度理解的工作上移动得更快。另一个用它来完全避免理解这项工作。循环不知道区别。你知道。
这就是为什么循环设计比提示工程更难,而不是更容易。Cherny 的观点不是说工作变简单了。而是说杠杆点移动了。
构建循环。但要像一个打算继续保持工程师身份的人那样去构建它,而不只是按下开始按钮的人。